OVHcloud dévoile Olala mini 7A1B, son premier LLM maison. Compact, open source et déjà utilisé par Qwant, il vise plus grand.
En bref
- OVHcloud lance son premier LLM maison
- Qwant l’utilise déjà en production
- La feuille de route vise 100B paramètres
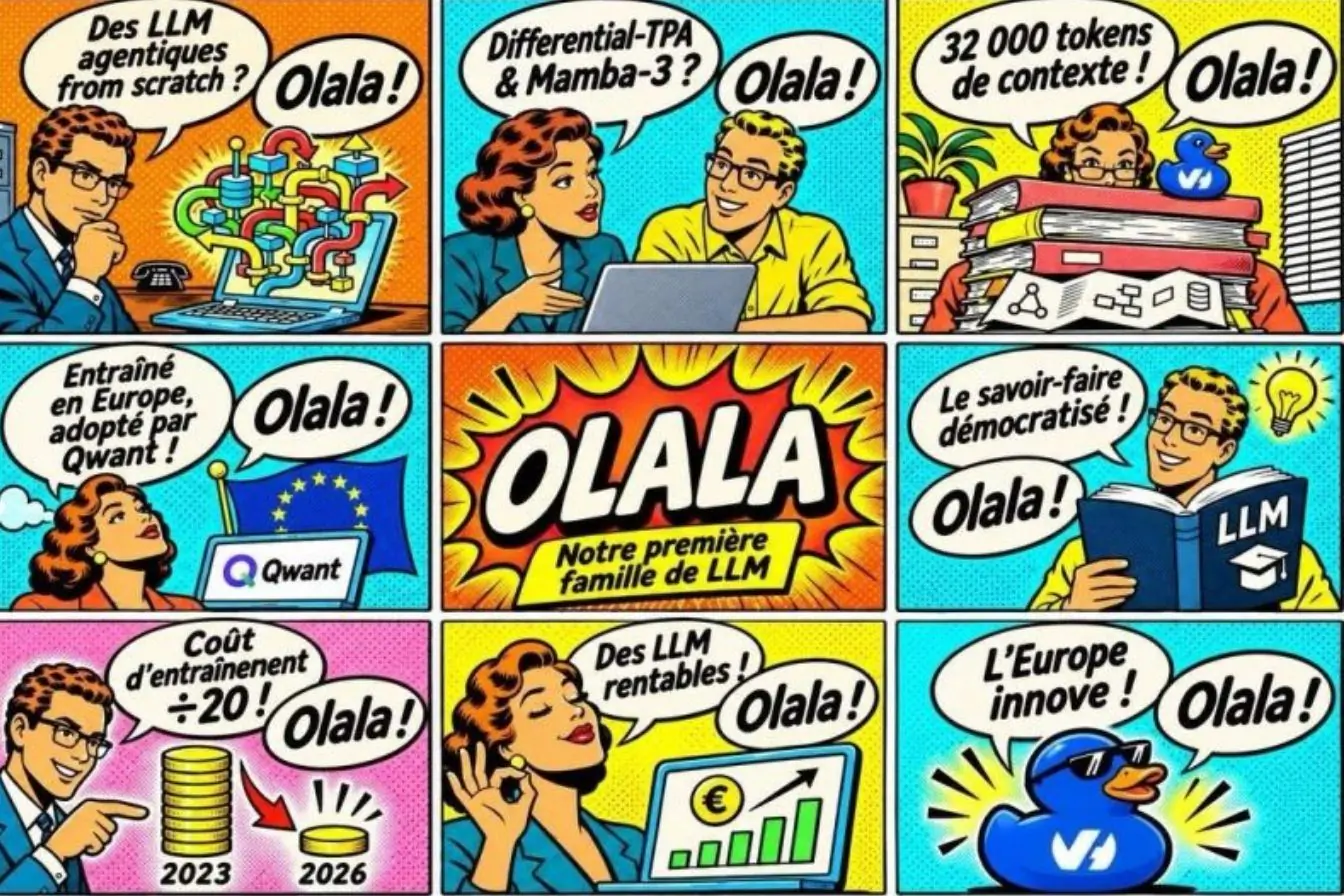
Un modèle qui tourne avec 8 Go de VRAM minimum, et qui trouve déjà sa place chez Qwant, ça mérite qu’on s’y arrête. Avec Olala mini 7A1B, OVHcloud ne se contente pas d’ajouter un logo de plus sur la carte de l’IA européenne. Le groupe montre surtout qu’un LLM compact peut viser un usage concret, rapide et moins coûteux.
Un LLM compact, pensé pour tourner partout
Sous le capot, Olala mini 7A1B repose sur 7 milliards de paramètres, avec seulement 1 milliard activé à chaque requête, réparti entre 256 experts par couche. L’architecture mélange attention hybride, Differential-TPA et Mamba-3, en format BF16. L’idée est simple: ne mobiliser qu’une fraction du modèle pour gagner en vitesse et en mémoire.
Résultat, le modèle tient sur un GPU doté d’au moins 8 Go de mémoire. OVHcloud annonce 160 tokens par seconde sur une RTX A4500, et 50 tokens par seconde sur un simple processeur, sans GPU. La fenêtre de contexte grimpe aujourd’hui à 32 000 tokens. Et le choix de l’open source n’est pas anecdotique: publication sur Hugging Face, sous licence Apache 2.0.
L’aide publique européenne a pesé lourd
Derrière ce lancement, il y a aussi trois machines bien connues du calcul intensif européen: Jean Zay, MeluXina et Jupiter. L’entraînement s’est appuyé sur des GPU A100, GH200 et H100. Le soutien public représente l’équivalent de 7 millions d’euros en heures de calcul.
Et ce n’est pas juste une ligne comptable. OVHcloud explique que cet effort a permis de bâtir une équipe IA dédiée et de faire émerger son Lab agentique, OVHai LLM. Le modèle arrive avec ses poids, sa base pré-entraînée, un rapport technique et sa documentation de conformité à l’AI Act.
Qwant sert déjà de preuve terrain
Là, on quitte le labo. Qwant utilise déjà Olala mini pour sa fonction de réponse flash. Les gains annoncés sont nets: des réponses 20 % plus rapides et des coûts d’exploitation divisés par trois par rapport au modèle précédent.
Pour l’écosystème, c’est probablement le point le plus intéressant. Un LLM européen, open source, déjà branché sur un service grand public, avec un bénéfice mesurable. Pas mal de projets s’arrêtent avant cette étape.
OVHcloud prépare déjà la suite, jusqu’à 100 milliards
La version 1.1 est attendue d’ici la fin de l’année. Elle doit porter le contexte à 128 000 tokens et améliorer le raisonnement mathématique. Puis viendra la v2.0, avec des modèles spécialisés pour trois terrains: la cybersécurité, le DevOps cloud et l’agentique pour l’entreprise.
À terme, Olala doit alimenter OVHai Workspace, y compris dans une version chiffrée capable de tourner en local sur le poste de travail. OVHcloud vise aussi des déclinaisons pour développeurs, architectes et équipes d’exploitation 24h/24. La v2.0 doit dépasser 100 milliards de paramètres. Son lancement officiel, lui, est fixé au 19 novembre lors de l’OVHcloud AI Summit. Octave Klaba résume la logique: « L’IA est stratégique pour OVH », et le groupe estime désormais possible d’entraîner des LLM de façon rentable, sans dépendre uniquement des labs qui publient en open source.
Face à Mistral, la bataille du coût et de l’usage
En Europe, OVHcloud arrive sur un terrain déjà disputé. Mistral AI propose notamment ses Ministral 3, des modèles de 3, 8 et 14 milliards de paramètres, sous licence Apache 2.0, conçus pour fonctionner sur des équipements locaux aux ressources limitées. La compacité et l’ouverture ne suffisent donc plus à se différencier.
Mistral AI L’atout potentiel d’OVHcloud réside dans sa capacité à réunir modèle, infrastructure et exploitation au sein d’une même offre pour ses clients cloud. Face à Mistral, l’enjeu sera de prouver qu’Olala répond mieux à certains besoins métiers, avec un coût total maîtrisé et une intégration simple.
L’utilisation par Qwant apporte une première validation en production, mais les gains annoncés ne permettent pas de situer Olala face à Mistral, faute de comparaison publique à conditions équivalentes. Pour l’IA européenne, cette concurrence peut surtout élargir le choix et réduire la dépendance à un fournisseur unique.